tl;dr
- Der KI-Kennzeichnungscheck übersetzt die Transparenzpflichten aus Art. 50 des EU AI Acts in einen verständlichen, kontextabhängigen Fragenpfad.
- Das Ergebnis erklärt nicht nur, ob eine Kennzeichnung relevant sein kann, sondern auch warum und welche Besonderheiten zu beachten sind.
- Ein integrierter Bildeditor ermöglicht die Kennzeichnung mit den offiziellen EU-Icons und eigenen Hinweisen direkt im Browser.
- Antworten und Bilder werden nicht hochgeladen oder gespeichert. Es gibt keine Nutzerkonten, Cookies, Historie oder Analytics.
- Technisch ist das Projekt bewusst schlank aufgebaut: Next.js, React, TypeScript, statischer Export und Deployment über Cloudflare Pages.
Kurzbeschreibung
Der KI-Kennzeichnungscheck ist ein kostenloses Webtool zur unverbindlichen Orientierung bei der Frage, ob KI-generierte oder KI-veränderte Inhalte nach Art. 50 des EU AI Acts offengelegt werden müssen.
Statt den Gesetzestext lediglich zusammenzufassen, führt das Tool durch einen kontextabhängigen Entscheidungsprozess. Ergänzend können Bilder direkt im Browser mit den offiziellen EU-Kennzeichnungsicons und einem eigenen Klartext-Hinweis versehen werden – ohne Upload, Account oder Speicherung.
Ausgangspunkt / Problemstellung
„Muss ich das jetzt kennzeichnen?“ ist eigentlich die falsche erste Frage
Seit dem 2. August 2026 gelten die Transparenzpflichten aus Art. 50 des EU AI Acts. Rund um den Stichtag tauchte entsprechend häufig eine scheinbar einfache Frage auf:
Müssen jetzt alle KI-generierten Inhalte gekennzeichnet werden?
Die kurze Antwort lautet: nein.
Die längere Antwort ist deutlich unbequemer.
Art. 50 unterscheidet unter anderem zwischen Anbietern und Betreibern von KI-Systemen, zwischen direkter KI-Interaktion und generierten Inhalten sowie zwischen Bildern, Audio, Video und bestimmten Texten. Bei Bildern und zeitbasierten Medien spielt beispielsweise eine Rolle, ob ein Deepfake vorliegt. Bei Texten kommt zusätzlich auf Veröffentlichungszweck, öffentliches Interesse sowie menschliche oder redaktionelle Kontrolle an.
Aus einer einfachen Ja-Nein-Frage wird damit ziemlich schnell ein Entscheidungsbaum.
Genau darin lag für mich das eigentliche Problem: Die Informationen waren vorhanden. Sie waren nur noch nicht besonders gut anwendbar.
Ein weiterer Artikel über den AI Act hätte daran wenig geändert.
Idee
Nicht noch mehr Recht erklären – sondern beim Anwenden helfen
Die Idee war deshalb, die Perspektive umzudrehen.
Nicht:
Was steht alles in Art. 50?
Sondern:
Was muss ich in meinem konkreten Fall eigentlich prüfen?
Daraus entstand ein geführter Kennzeichnungscheck. Nutzer beantworten nur die Fragen, die für ihren jeweiligen Anwendungsfall relevant sind. Der Pfad verändert sich abhängig von Kontext, Inhaltstyp und vorherigen Antworten.
Am Ende steht kein abstraktes „Ja“ oder „Nein“, sondern eine Einordnung mit Begründung.
Der zweite Teil des Projekts entstand fast automatisch aus der nächsten praktischen Frage:
Wenn ich kennzeichnen möchte oder muss – wie mache ich das jetzt?
Die EU stellt dafür eigene Icons bereit. Also wurde aus dem reinen Entscheidungstool zusätzlich ein kleiner lokaler Bildeditor.
Der Check übersetzt regulatorische Anforderungen in einen Entscheidungsprozess und verbindet die Einordnung direkt mit einer möglichen Umsetzung.
Hypothese
Regulatorische Anforderungen werden für Menschen nicht dadurch einfacher, dass man sie kürzer zusammenfasst. Sie werden einfacher, wenn man sie in den konkreten Entscheidungskontext übersetzt.
Dahinter steckt für mich ein allgemeineres Prinzip.
Viele Compliance-Probleme sind eigentlich keine Informationsprobleme. Die Verordnung, Leitlinie oder interne Richtlinie existiert bereits. Was fehlt, ist die Übersetzung von abstraktem Wissen in einen konkreten nächsten Schritt.
Ein gutes Interface kann dabei nicht die fachliche oder rechtliche Bewertung ersetzen. Es kann aber die richtigen Fragen in der richtigen Reihenfolge stellen.
Genau diese Grenze war für das Projekt wichtig: Orientierung statt Rechtsberatung.
Warum das relevant ist
Art. 50 zeigt ziemlich gut, was bei Regulierung regelmäßig passiert: Die einzelne Vorschrift ist nur ein Teil des Problems.
In der praktischen Anwendung muss ein Unternehmen zunächst verstehen, welche Rolle es einnimmt, welche Art von Inhalt vorliegt, wie dieser erzeugt oder verändert wurde und in welchem Kontext Menschen damit in Kontakt kommen.
Bei generativen Inhalten kommt eine weitere Ebene hinzu: sichtbare Offenlegung und technische Markierung sind nicht dasselbe.
Anbieter generativer KI-Systeme können beispielsweise Pflichten zur maschinenlesbaren Markierung ihrer Ausgaben treffen. Wer einen Inhalt beruflich einsetzt oder veröffentlicht, muss dagegen in bestimmten Situationen gegenüber dem Publikum offenlegen, dass KI-generierte oder manipulierte Inhalte verwendet wurden.
Ein sichtbares Icon löst deshalb nicht automatisch jedes Compliance-Problem.
Genau deshalb beschreibt auch der Kennzeichnungscheck die EU-Icons bewusst als Hilfsmittel und nicht als „Compliance-Button“.
Ansatz
Erst schnell sichtbar machen, dann konsequent vereinfachen
Die erste Version entstand als schneller Prototyp mit KI-Unterstützung. Ausgangspunkt war ChatGPT Sites, um Struktur, Informationsarchitektur und Interaktion möglichst schnell greifbar zu machen.
Danach wurde das Projekt exportiert und lokal weiterbearbeitet. Mit Codex wurden Struktur, Logik und technische Umsetzung schrittweise überarbeitet und anschließend in ein eigenes Git-Repository überführt.
Dabei wurde relativ schnell deutlich, dass der eigentliche technische Bedarf kleiner war als der ursprüngliche Prototyp.
Das Tool braucht keine Benutzerverwaltung.
Es braucht keine Datenbank.
Es braucht keine serverseitige Historie.
Und es braucht auch keine Persistenz für die eingegebenen Antworten.
Nicht benötigte Server-, ORM- und Persistenzbausteine konnten deshalb wieder entfernt werden. Aus dem Prototyp wurde bewusst eine statische Anwendung.
Entscheidungslogik statt statischer Checkliste
Der Kennzeichnungscheck ist nicht als lange Liste von Fragen aufgebaut.
Der erste Schritt prüft beispielsweise den Nutzungskontext. Danach werden nur noch Fragen angezeigt, die für die vorherigen Antworten relevant sind. Bild, Video, Audio und Text führen dadurch teilweise zu unterschiedlichen Pfaden.
Das Ergebnis erklärt anschließend die Einordnung und verweist auf die dafür relevanten rechtlichen Grundlagen.
Damit bleibt der rechtliche Kontext sichtbar, ohne den Nutzer direkt mit der vollständigen Regulierung allein zu lassen.
Bildeditor: Kennzeichnen ohne Upload
Der Bildeditor arbeitet vollständig lokal im Browser.
Bilder werden über die Browser-Schnittstellen geöffnet und im Arbeitsspeicher verarbeitet. Über ein Canvas werden Icon und optionaler Zusatztext auf das Bild gelegt.
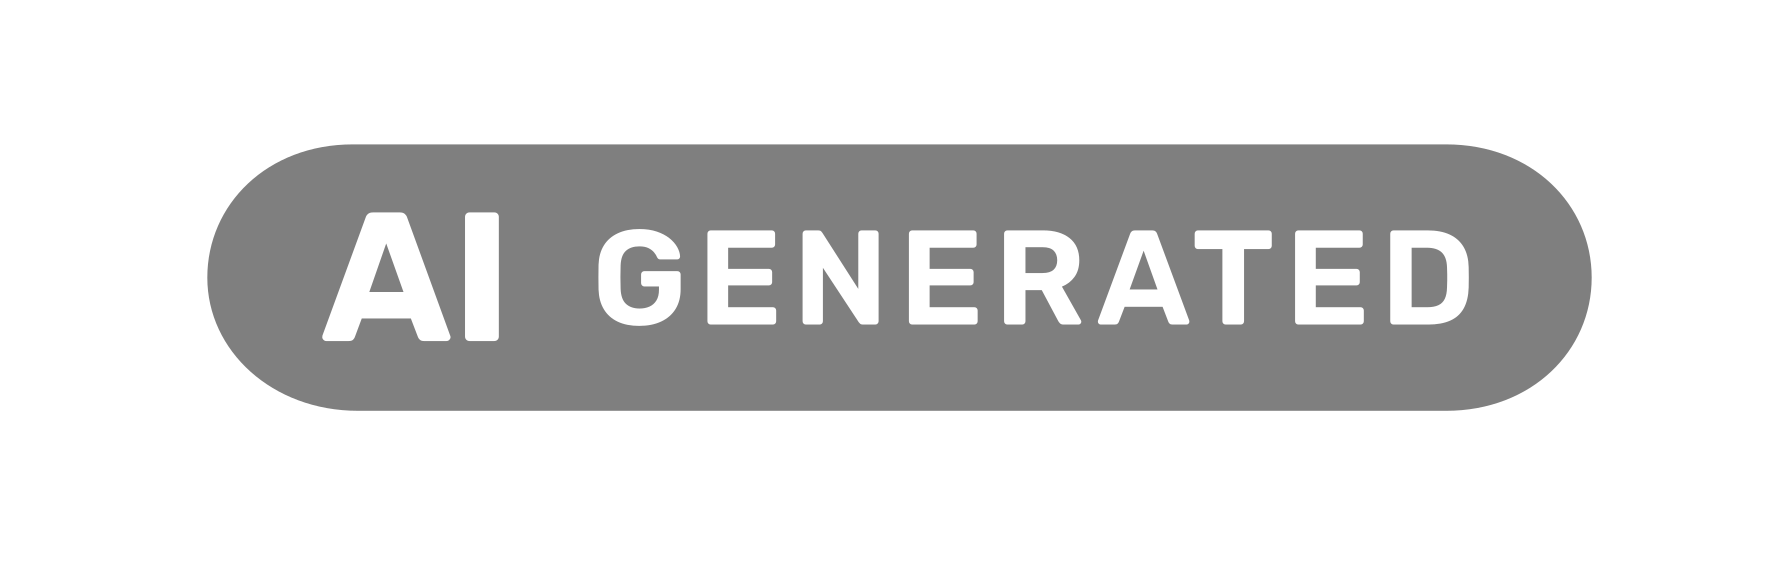
Zur Verfügung stehen das Basis-Icon, die Kennzeichnung für vollständig KI-generierte Inhalte und die Kennzeichnung für teilweise KI-veränderte Inhalte. Position, Größe, Kontrast und Zusatztext können angepasst werden.
Auch Stapelverarbeitung ist möglich: Mehrere Bilder können mit denselben Einstellungen versehen und anschließend einzeln oder gemeinsam als ZIP-Datei exportiert werden.
Der entscheidende Punkt ist dabei weniger der Editor selbst.
Der entscheidende Punkt ist, was nicht passiert:
Kein Bild wird für die Bearbeitung an meinen Server übertragen.
Datenschutz und Sicherheit by default
Die Architektur folgt hier einer ziemlich simplen Überlegung:
Daten, die ich nicht brauche, muss ich auch nicht sammeln, schützen oder löschen.
Antworten aus dem Check bleiben ausschließlich im Arbeitsspeicher des geöffneten Browser-Tabs. Auch die Bildverarbeitung erfolgt lokal.
Es gibt keine Nutzerkonten, keine Upload-Historie, keine Cookies und aktuell auch kein Analytics.
PostHog war während der Entwicklung durchaus eine Option. Ich habe die Integration aber bewusst zurückgestellt. Für den aktuellen Zweck ist der Erkenntnisgewinn durch Tracking geringer als die zusätzliche technische und datenschutzrechtliche Komplexität.
Damit benötigt die Anwendung aktuell auch keine zusätzliche Consent-Management-Lösung für Analyse- oder Marketingdienste.
Für das Deployment werden zusätzlich Sicherheitsheader über Cloudflare Pages gesetzt. Die Content-Security-Policy ist so eingeschränkt, dass primär Ressourcen der eigenen Domain sowie die für die lokale Bildverarbeitung notwendigen Browser-Quellen verwendet werden können.
Datenschutz ist damit kein zusätzlicher Banner am Ende der Entwicklung, sondern Teil der technischen Reduktion.
Technischer Aufbau
Der aktuelle Stand basiert auf Next.js 16 mit App Router, React 19 und TypeScript.
Die Anwendung wird vollständig statisch exportiert und benötigt im Produktivbetrieb keine Next.js-Server-Runtime. Die Bildbearbeitung erfolgt über Browser-Canvas, der lokale ZIP-Export über fflate.
Schriftarten, Icons und weitere benötigte Assets liegen lokal in der Anwendung.
Die Anwendung benötigt für Check und Bildbearbeitung kein Backend und keine Persistenz.
Auch SEO und technische Auffindbarkeit wurden für die produktive Version ergänzt. Dazu gehören unter anderem korrekte Metadaten und Canonical-Angaben sowie robots.txt und sitemap.xml.
Impressum und Datenschutzerklärung werden nicht noch einmal separat gepflegt, sondern zentral über meine persönliche Website bereitgestellt.
Aktueller Stand
Produktiv / aktiv – der KI-Kennzeichnungscheck ist als eigenständige Webanwendung veröffentlicht und kann ohne Anmeldung genutzt werden.
Der Kennzeichnungscheck deckt Bild, Video, Audio und Text ab und liefert kontextabhängige Ergebnisse mit Begründung. Der Bildeditor unterstützt die offiziellen EU-Icons, Zusatztexte, Skalierung und Positionierung sowie die lokale Einzel- und Stapelverarbeitung.
Die Anwendung ist responsiv und tastaturbedienbar. Primärquellen und Praxisfälle sind direkt in die Seite integriert.
Die produktive Fassung verfügt außerdem über Canonical- und Social-Media-Metadaten, Sitemap, Robots-Konfiguration sowie restriktive Sicherheitsheader.
Analytics bleibt vorerst bewusst deaktiviert.
Erkenntnisse
Regulierung braucht ein Interface
Der größte Lernpunkt ist für mich nicht technischer Natur.
Regulatorische Texte sind Wissensquellen. Ein Nutzer braucht aber meistens keine Wissensquelle, sondern eine Entscheidungshilfe.
Zwischen diesen beiden Ebenen liegt Übersetzungsarbeit.
Weniger Architektur war hier die bessere Architektur
Im ersten Prototyp waren mehr technische Möglichkeiten vorhanden, als das eigentliche Produktproblem benötigte.
Die Reduktion auf einen statischen Export macht die Anwendung einfacher zu deployen, einfacher zu warten und reduziert gleichzeitig Datenschutz- und Sicherheitsrisiken.
Nicht jede Webanwendung braucht ein Backend.
Privacy by Design kann sehr banal sein
Datenschutz wird häufig als zusätzliche Compliance-Schicht betrachtet.
Hier entstand er vor allem durch Weglassen.
Keine Accounts. Keine Datenbank. Keine Bild-Uploads. Keine Historie. Kein Analytics.
Das ist nicht für jede Anwendung möglich. Wenn es möglich ist, sollte die Frage aber zumindest gestellt werden.
Ein rechtliches Tool braucht eine andere Quellenhierarchie
Bei einem technischen Experiment kann eine gute Dokumentation oder ein GitHub-Repository als Quelle ausreichend sein.
Bei einem Tool zu regulatorischen Pflichten ist das anders.
Deshalb basiert die inhaltliche Logik primär auf dem verbindlichen EU-Verordnungstext sowie den offiziellen Leitlinien, FAQ, Icons und Umsetzungshilfen der Europäischen Kommission.
Sekundärquellen helfen beim Verständnis. Sie sollten aber nicht die eigentliche Entscheidungslogik bestimmen.
KI beschleunigt Umsetzung – nicht Verantwortung
Das Projekt selbst ist mit starker KI-Unterstützung entstanden.
Gerade deshalb ist es ein interessantes Beispiel für den Unterschied zwischen Generierung und Verantwortung.
KI konnte beim Strukturieren, Entwerfen, Implementieren und Prüfen unterstützen. Die Entscheidung, welche Quellen belastbar sind, welche Aussagen zu weit gehen und welche Funktion tatsächlich in das Produkt gehört, bleibt trotzdem eine menschliche Aufgabe.
Nächste Schritte
Der höchste Hebel liegt aktuell nicht darin, noch mehr Features einzubauen.
Art. 50 ist kein abgeschlossenes Wissensgebiet. Leitlinien, FAQ, Behördenpraxis und technische Standards werden sich weiterentwickeln. Die wichtigste Aufgabe ist deshalb zunächst, Entscheidungslogik und Quellenstand aktuell zu halten.
Auch die Praxisfälle können mit realen Fragestellungen erweitert werden, wenn dadurch neue Grenzfälle verständlicher werden.
Analytics bleibt weiterhin eine bewusste spätere Entscheidung. Erst wenn konkrete Produktfragen existieren, die sich ohne Nutzungsdaten nicht sinnvoll beantworten lassen, lohnt sich die zusätzliche Komplexität.
Der Fokus bleibt damit vorerst: klein, nachvollziehbar und aktuell halten.
Persönliche Note
Das Projekt passt ziemlich gut zu einer Art von Problem, die mir immer wieder begegnet.
Die Information ist eigentlich da.
Trotzdem weiß niemand so richtig, was jetzt zu tun ist.
Dann fehlt häufig nicht noch ein Dokument, sondern eine Übersetzung zwischen Fachwissen, Prozess und konkreter Handlung.
Genau das reizt mich an solchen kleinen Tools.
Aus einem relativ sperrigen Thema wie Art. 50 wird kein „einfaches Gesetz“. Das wäre auch die falsche Behauptung.
Aber aus dem Gesetz kann ein verständlicher Entscheidungsprozess werden.
Und aus der Frage „Wie kennzeichne ich das jetzt?“ kann direkt eine kleine Anwendung entstehen, mit der sich der nächste Schritt umsetzen lässt.
Technologie folgt dabei dem Problem – nicht umgekehrt.
Fazit
Der KI-Kennzeichnungscheck ist bewusst kein Legal-Tech-System und kein Ersatz für eine juristische Prüfung.
Er ist ein Übersetzungswerkzeug.
Er verbindet regulatorische Anforderungen mit einem nachvollziehbaren Fragenpfad und einem konkreten Werkzeug zur praktischen Umsetzung. Gleichzeitig zeigt das Projekt, wie weit sich eine Anwendung reduzieren lässt, wenn Datenhaltung, Tracking und Backend für das eigentliche Problem schlicht nicht notwendig sind.
Für mich ist genau das die spannendere Form von Digitalisierung:
Nicht mehr Technologie.
Sondern die richtige Menge Technologie an der richtigen Stelle.
Quellen & weiterführende Informationen
Die inhaltliche Entscheidungslogik basiert vorrangig auf dem EU AI Act, insbesondere Art. 50, den Leitlinien der Europäischen Kommission zu den Transparenzpflichten, den offiziellen Fragen und Antworten zu Art. 50, den offiziellen EU-Icons zur Kennzeichnung KI-generierter Inhalte sowie dem Code of Practice on Transparency of AI-generated Content.
Der Kennzeichnungscheck selbst enthält den jeweils zugrunde gelegten Rechtsstand, die Primärquellen und Hinweise zur Einordnung direkt innerhalb der Anwendung.
Transparenzhinweis
Text: Dieser Beitrag wurde mit Unterstützung von Künstlicher Intelligenz erstellt und vor Veröffentlichung von mir persönlich geprüft und überarbeitet.
FAQ
Was ist der KI-Kennzeichnungscheck?
Der KI-Kennzeichnungscheck ist ein kostenloses Webtool zur unverbindlichen Orientierung bei Transparenz- und Offenlegungspflichten nach Art. 50 des EU AI Acts. Ein kontextabhängiger Fragenpfad hilft dabei, den eigenen Anwendungsfall strukturiert einzuordnen.
Muss jeder KI-generierte Inhalt gekennzeichnet werden?
Nein. Art. 50 enthält keine pauschale Kennzeichnungspflicht für sämtliche KI-generierten Inhalte. Entscheidend sind unter anderem Inhaltstyp, Verwendungskontext, die Rolle des Anwenders sowie bei bestimmten Inhalten weitere Kriterien wie Deepfake-Eigenschaften oder menschliche redaktionelle Kontrolle.
Ersetzt der Check eine Rechtsberatung?
Nein. Der Check dient ausschließlich der allgemeinen Orientierung und kann eine Prüfung des konkreten Einzelfalls durch entsprechend qualifizierte Fachpersonen nicht ersetzen.
Werden meine Antworten oder Bilder gespeichert?
Nein. Antworten aus dem Check bleiben im Arbeitsspeicher des geöffneten Browser-Tabs. Bilder werden lokal im Browser geöffnet, bearbeitet und exportiert. Es gibt keine Upload-Historie, Nutzerkonten oder serverseitige Persistenz.
Sind die EU-Icons verpflichtend?
Die von der EU bereitgestellten Icons sind ein freiwilliges Hilfsmittel zur verständlichen Offenlegung KI-generierter oder KI-manipulierter Inhalte. Die Verwendung eines Icons allein stellt keine rechtliche Konformität sicher.
Welche Technologie steckt hinter dem Projekt?
Die Anwendung basiert auf Next.js 16, React 19 und TypeScript und wird vollständig statisch exportiert. Die Bildbearbeitung erfolgt über Browser-Canvas, auch der ZIP-Export wird lokal im Browser erzeugt. Für den Betrieb werden keine Datenbank und keine serverseitige Anwendung benötigt.
Warum gibt es kein Analytics oder Cookie-Banner?
Analytics ist aktuell bewusst nicht integriert. Da keine Analyse- oder Marketingdienste eingesetzt werden und die Anwendung keine Cookies für diese Zwecke setzt, wird derzeit auch keine zusätzliche Consent-Management-Lösung dafür benötigt.